
1줄 요약: 데이터클리닝 방법은 코딩 오류 수정, 불성실 응답 제거, 문항 정제, 왜도·첨도 보정 순서로 진행해요. 통계를 몰라도 머스트논문이 대안까지 안내해요!
설문 데이터를 어렵게 모았는데 신뢰도 알파가 낮게 나오거나 왜도·첨도가 기준을 넘어서 분석을 시작도 못 하셨나요? 지도교수님께 “신뢰도가 이래서야 쓰겠어요?”라는 말을 들으면 눈앞이 캄캄해지죠. 저도 그 심정을 잘 알아요.
이런 문제는 원인이 데이터 상태에 있는 경우가 많아요. 이 글에서는 통계분석 방법을 잘 몰라도 따라 할 수 있는 데이터클리닝 방법을 순서대로 알려드릴게요!
데이터클리닝 방법은 통계분석 전에 왜 꼭 필요한가요?
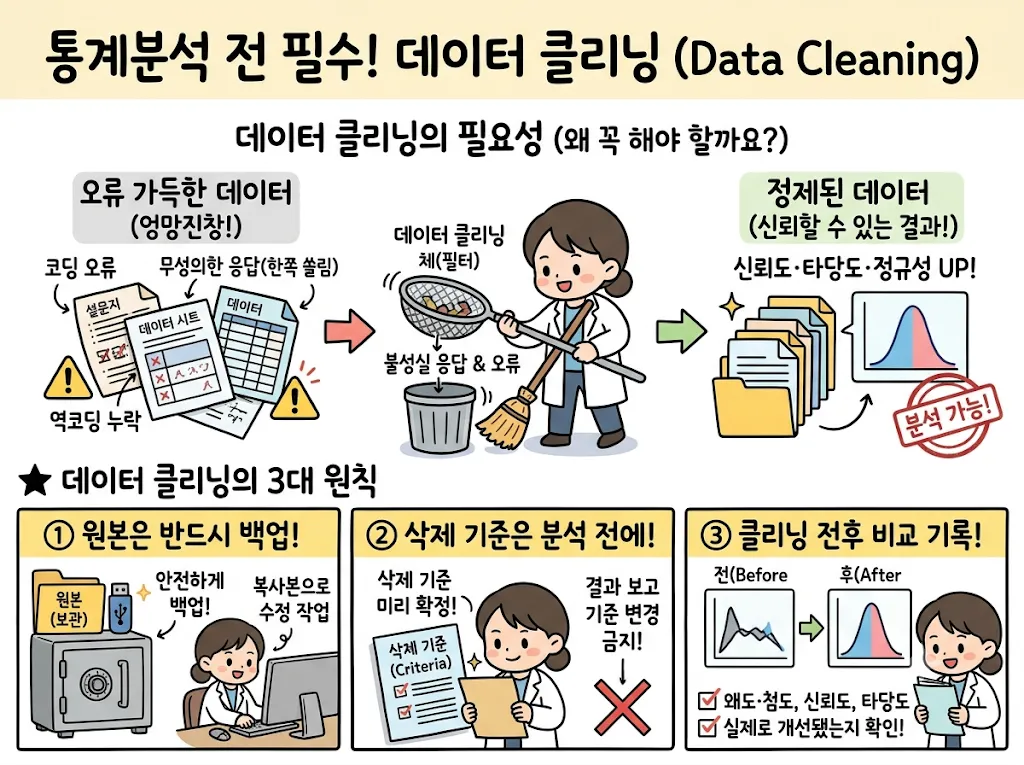
데이터클리닝은 분석 전에 코딩 오류와 불성실 응답을 걸러서 정규성과 신뢰도·타당도를 확보하는 작업이에요. 이 과정을 건너뛰면 어떤 분석 기법을 써도 결과를 믿기 어려워요.
- 역코딩이 누락되면 신뢰도(Cronbach’s α)가 급격히 떨어지거나 음수가 나와요.
- 한쪽으로 쏠린 무성의한 응답이 섞이면 정규성이 깨지고 문항 간 상관관계가 무너져요.
- 개념을 제대로 재지 못하는 문항이 남아 있으면 타당도가 낮게 나와요.
데이터클리닝 방법에는 지켜야 할 원칙이 세 가지 있어요.
- 원본을 반드시 백업해요. 수정은 복사본에서 해요.
- 삭제 기준을 분석 전에 정해요. 결과를 보고 나서 기준을 바꾸면 안 돼요.
- 클리닝 전후를 비교해 기록해요. 왜도·첨도, 신뢰도, 타당도가 실제로 개선됐는지 확인하세요.
데이터클리닝 방법 1단계, 코딩 오류는 어떻게 잡나요?
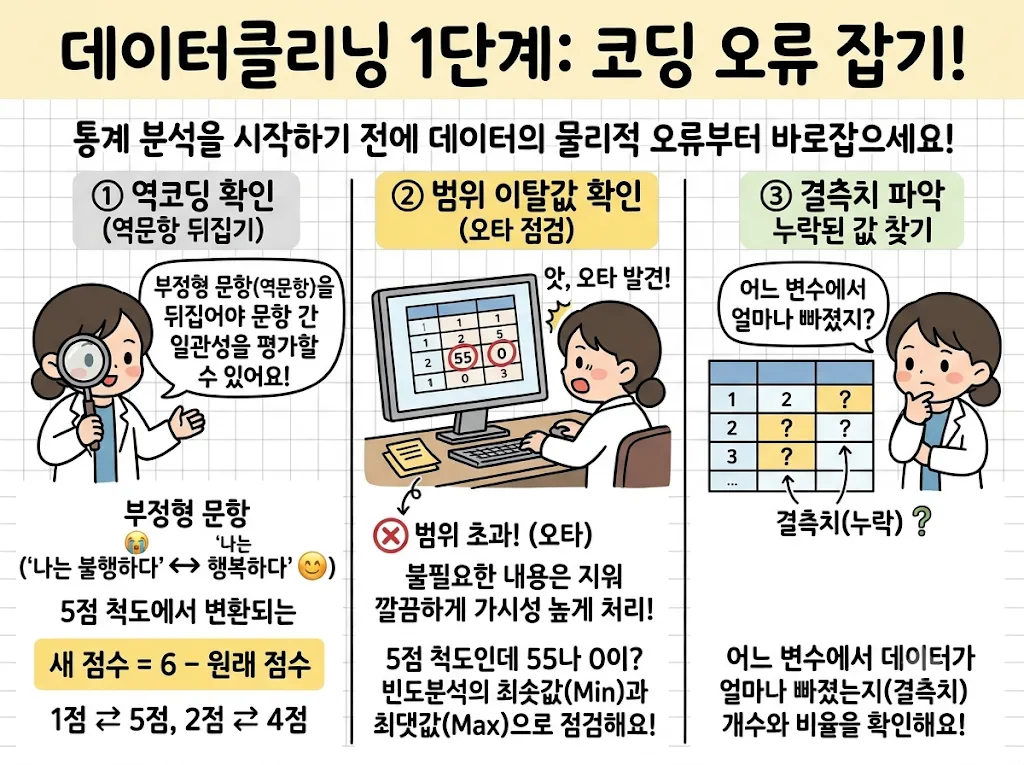
통계 기법을 쓰기 전에 데이터의 물리적 오류부터 바로잡으세요.
- 역코딩 확인: 부정형 문항(역문항)이 제대로 뒤집혀 있는지 확인해요. 5점 척도라면 새 점수 = 6 − 원래 점수예요. 역문항은 먼저 원래 방향으로 재코딩해야 문항 간 일관성을 제대로 평가할 수 있어요.
- 범위 이탈값 확인: 5점 척도인데 ‘55’나 ‘0’이 입력된 오타가 없는지 빈도분석의 최솟값과 최댓값으로 점검해요.
- 결측치 파악: 어느 변수에서 얼마나 빠졌는지부터 확인해요.
함께 보면 좋은 글 ▶ 통계교수님 공격 0으로 만드는 결측치 처리 방법 3가지? 논문통과율 높이는 완벽 방어 서술 전략 대공개!
불성실 응답자는 어떻게 걸러내나요?
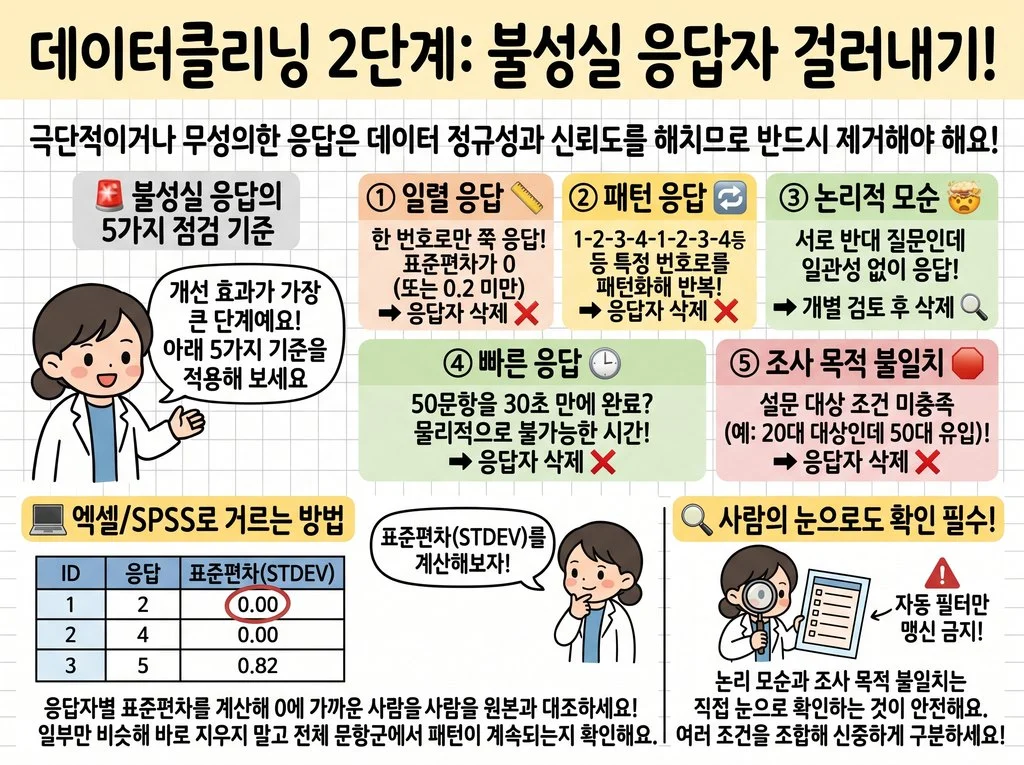
데이터클리닝 방법 중 개선 효과가 가장 큰 단계가 불성실 응답 제거예요. 한쪽으로 쏠린 극단 응답과 무성의한 응답은 정규성과 신뢰도를 동시에 해쳐요.
| 점검 항목 | 판단 기준 | 처리 방법 |
|---|---|---|
| 일렬 응답 | 측정 문항들의 표준편차가 0(엄격하게는 0.2 미만) | 응답자 삭제 |
| 패턴 응답 | 특정 번호를 반복 선택 | 응답자 삭제 |
| 논리적 모순 | 서로 반대 방향 문항에서 일관성 없음 | 개별 응답 검토 후 삭제 |
| 빠른 응답 | 읽고 답하기 물리적으로 불가능한 시간(예: 50문항을 30초에 완료) | 응답자 삭제 |
| 조사 목적 불일치 | 선정 조건 미충족 | 응답자 삭제 |
엑셀이나 SPSS에서 응답자별로 문항군의 표준편차를 계산하고, 0에 가까운 응답자를 따로 뽑아 원본과 대조하세요. 일부 문항만 비슷하다고 바로 지우지 말고 전체 문항군에서 계속되는지 확인해야 해요.
자동 필터링만 믿지 마세요. 논리 모순과 조사 목적 불일치는 개별 응답을 눈으로 확인하는 편이 안전해요. 신뢰도와 타당도가 함께 낮다면 여러 조건을 조합해서 불성실 응답자를 구분하세요.
이상치와 결측치는 어떻게 처리하나요?
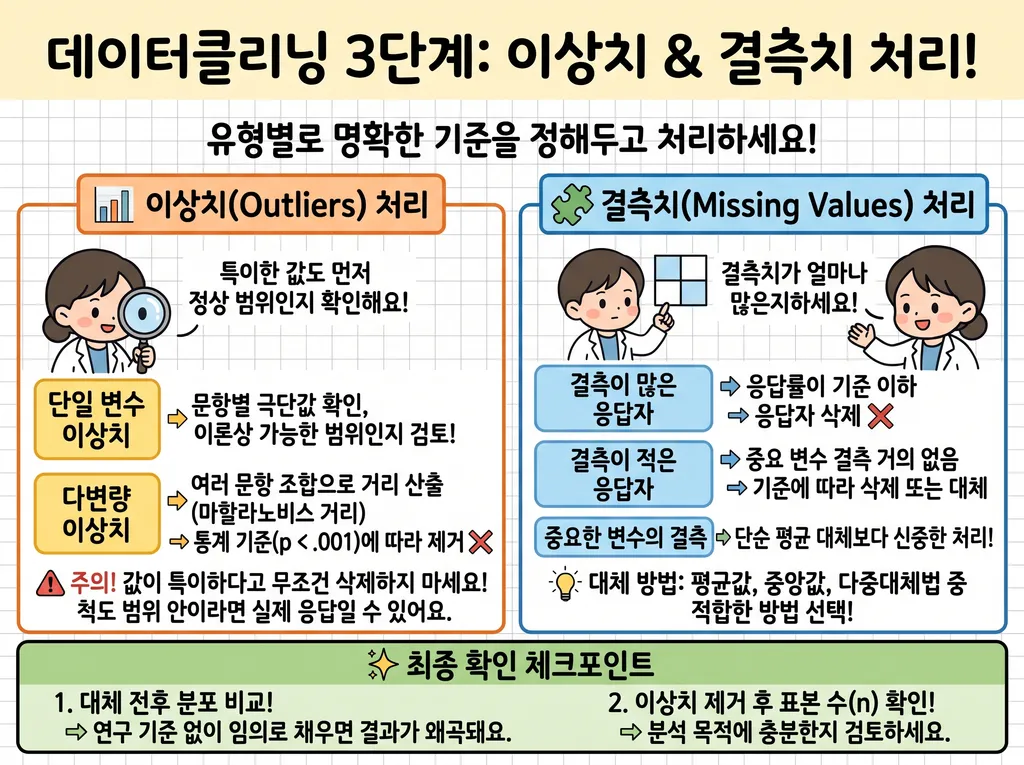
이상치와 결측치는 유형별로 기준을 미리 정해 두고 처리하세요.
| 유형 | 확인 방법 | 처리 기준 |
|---|---|---|
| 단일 변수 이상치 | 문항별 분포와 극단값 확인 | 이론상 가능한 범위인지 검토 |
| 다변량 이상치 | 여러 문항 조합으로 거리 산출(마할라노비스 거리) | 사전에 정한 통계 기준(예: p < .001)에 따라 제거 |
| 결측이 많은 응답자 | 응답률이 일정 기준 이하 | 응답자 삭제 |
| 결측이 적은 응답자 | 주요 변수 결측이 거의 없음 | 연구 기준에 따라 삭제 또는 대체 |
| 중요한 변수의 결측 | 주요 분석 변수에 결측 발생 | 단순 평균 대체보다 신중한 처리 |
값이 특이하다는 이유만으로 삭제하지 마세요. 척도의 정상 범위 안에 있다면 실제 응답일 수 있어요. 불성실 응답이나 논리 모순이 함께 보일 때 제거하는 게 타당해요.
결측치를 대체할 때는 평균값·중앙값·다중대체법 중에서 고를 수 있어요. 연구 기준 없이 임의로 평균을 채우면 결과가 왜곡되니 대체 전후의 분포 변화를 비교하세요. 이상치를 제거한 뒤에는 남은 표본이 분석 목적에 충분한지도 꼭 확인해야 해요.
신뢰도와 타당도가 낮을 때 문항 정제는 어떻게 하나요?
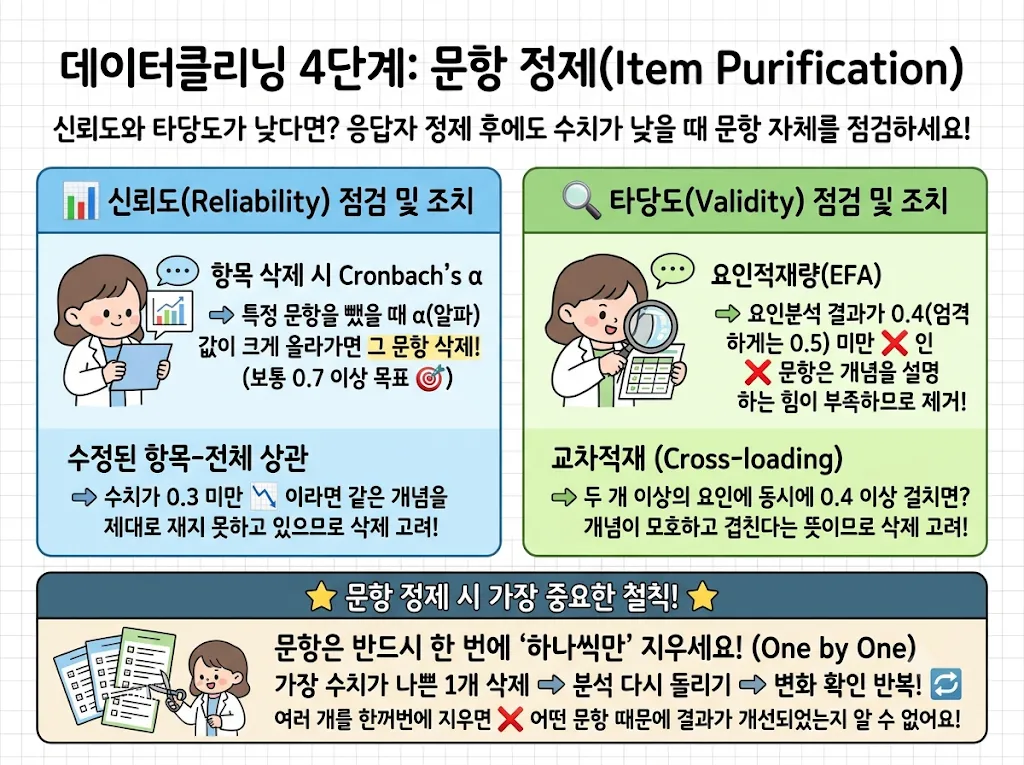
응답자를 정제한 뒤에도 수치가 낮다면 문항 자체를 점검하세요. 이 과정을 문항 정제(Item Purification)라고 해요.
| 점검 항목 | 확인 지표 | 실질적 조치 |
|---|---|---|
| 신뢰도 | 항목 삭제 시 Cronbach’s α | 특정 문항을 뺐을 때 알파가 크게 오르면 그 문항 삭제(보통 0.7 이상 목표) |
| 신뢰도 | 수정된 항목-전체 상관 | 0.3 미만이면 같은 개념을 못 재고 있으니 삭제 고려 |
| 타당도 | 요인적재량(EFA) | 0.4(엄격하게는 0.5) 미만 문항 제거 |
| 타당도 | 교차적재 | 두 개 이상 요인에 동시에 0.4 이상 걸리면 개념이 모호하니 삭제 |
문항은 한 번에 하나씩만 지우세요. 가장 수치가 나쁜 문항 1개를 지우고 분석을 다시 돌린 뒤 변화를 확인하는 과정을 반복해요. 여러 개를 한꺼번에 지우면 무엇이 개선을 가져왔는지 알 수 없어요.
왜도와 첨도가 기준을 넘으면 데이터클리닝 방법은 어떻게 이어지나요?
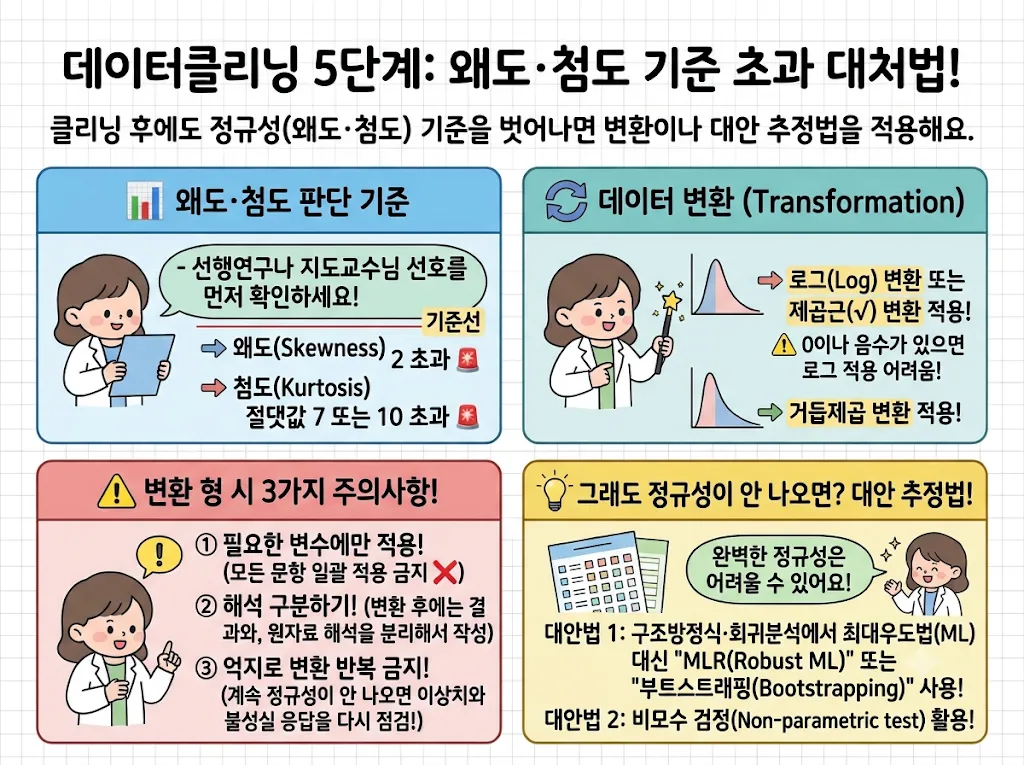
클리닝 후에도 왜도·첨도가 기준을 벗어나면 변환이나 대안 추정법을 적용해요. 기준은 보통 왜도 절댓값 2 또는 3, 첨도 절댓값 7 또는 10을 써요. 어느 기준을 쓸지는 선행연구와 지도교수님 선호를 확인해 정하세요.
| 작업 | 적용 상황 | 주의점 |
|---|---|---|
| 로그 변환 | 오른쪽으로 꼬리가 긴 분포(양의 왜도) | 0이나 음수가 있으면 그대로 적용하기 어려워요 |
| 제곱근 변환 | 오른쪽으로 꼬리가 긴 분포 | 로그 변환처럼 분포를 완화해요 |
| 거듭제곱 변환 | 왼쪽으로 꼬리가 긴 분포(음의 왜도) | 변환 전후를 비교해요 |
- 필요한 변수에만 적용해요. 모든 문항에 일괄 적용하지 마세요.
- 해석을 구분해요. 변환 후에는 원래 척도의 해석이 어려워지니 분석 결과와 원자료 해석을 분리해서 쓰세요.
- 변환을 연달아 강제하지 마요. 변환해도 정규성이 안 나오면 이상치와 불성실 응답을 다시 점검하는 편이 안전해요.
리커트 척도 설문은 완벽한 정규성이 나오기 어려워요. 클리닝 후에도 정규성이 확보되지 않으면 대안이 있어요. 회귀분석이나 구조방정식에서 최대우도법(ML) 대신 MLR(Robust Maximum Likelihood)이나 부트스트래핑을 쓰면 정규성 가정을 어겨도 타당한 결과를 얻을 수 있어요. 비모수 검정도 선택지예요.
데이터클리닝 방법은 어떤 순서로 적용해야 하나요?
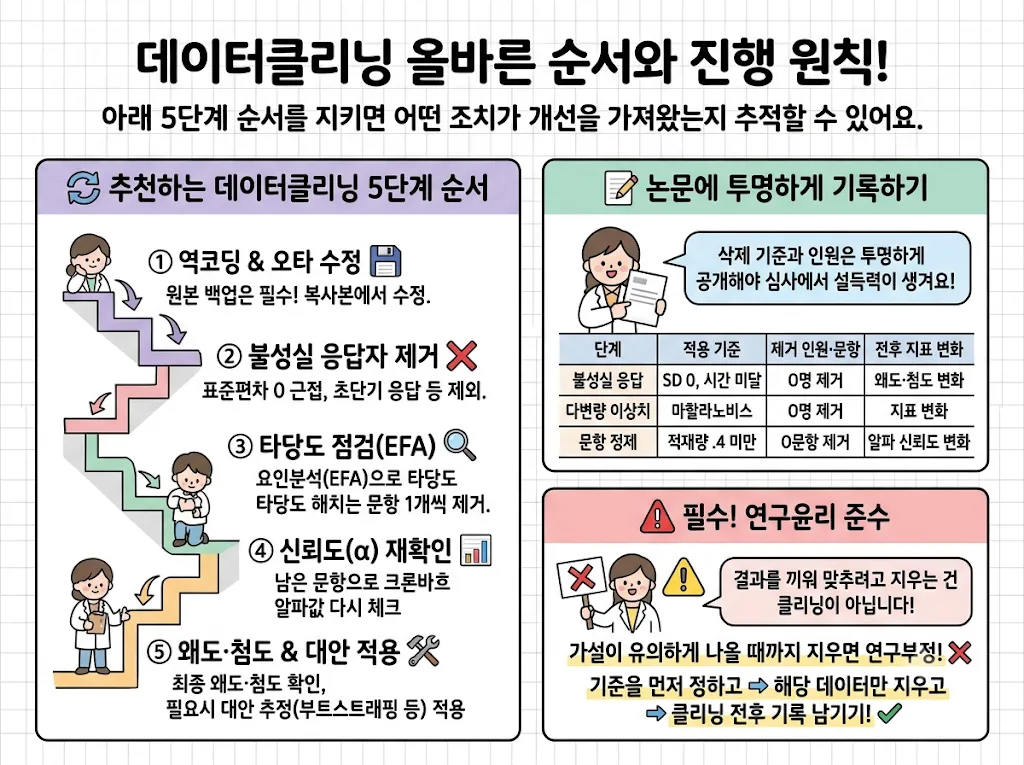
아래 5단계 순서를 지키면 어떤 조치가 개선을 가져왔는지 추적할 수 있어요.
- 역코딩과 오타를 수정한 뒤 저장해요. 원본 백업은 필수예요.
- 불성실 응답자(표준편차 0 근접, 초단기 응답)를 제거해요.
- 탐색적 요인분석(EFA)으로 타당도를 해치는 문항을 1개씩 제거해요.
- 남은 문항으로 신뢰도(Cronbach’s α)를 재확인해요.
- 최종 데이터의 왜도·첨도를 확인하고 필요하면 부트스트래핑을 적용해요.
삭제 기준과 인원은 논문에 투명하게 쓰세요. 아래처럼 정리해 두면 심사에서 설득력이 생겨요. 수치는 형식을 보여 드리려는 예시값이에요.
| 단계 | 적용 기준(분석 전 설정) | 제거 인원·문항 | 전후 지표 변화 |
|---|---|---|---|
| 불성실 응답 | 문항군 표준편차 0, 응답 시간 하한 미달 | 예시값 | 왜도·첨도 변화 예시값 |
| 다변량 이상치 | 마할라노비스 거리 p < .001 | 예시값 | 예시값 |
| 문항 정제 | 항목-전체 상관 .3 미만, 적재량 .4 미만 | 예시값 | 알파 변화 예시값 |
결과를 원하는 쪽으로 만들려고 지우는 건 데이터클리닝이 아니에요. 가설이 유의하게 나올 때까지 응답자나 문항을 삭제하면 연구윤리 문제가 돼요. 기준을 먼저 정하고, 기준에 해당하는 데이터만 지우고, 기록을 남기세요.
함께 보면 좋은 글 ▶ 논문 심사 후 데이터 오류 발견 시, 당장 대처해야 할 3가지 심폐소생 전략은?
데이터클리닝 방법을 몰라도 머스트논문은 어떻게 도와주나요?
통계분석 방법을 전혀 몰라도 괜찮아요. 머스트논문이 분석 전 데이터클리닝부터 최적의 분석 상태까지 안내해요. 가설을 좋게 만드는 게 아니라 분석에 가장 알맞은 신뢰할 수 있는 데이터 상태로 정리해 드리는 거예요.
- 데이터 진단: 코딩 오류, 불성실 응답, 문항 문제를 점검해서 어디가 원인인지 알려 드려요.
- 기준 설계: 삭제 기준을 분석 전에 정하고 전후 비교 기록을 남겨요.
- 적절한 대안 제시: 변환, MLR, 부트스트래핑, 비모수 검정 중 데이터에 맞는 방법을 제안해요.
- 분석과 해석: 클리닝 이후의 통계분석과 결과 해석, 논문 기술까지 이어 드려요.
머스트논문은 논문컨설팅뿐 아니라 합리적인 비용으로 논문통계를 맡길 수 있는 업체예요. 탑클래스 논문컨설팅사 7년 실무 경력의 박사가 설립했고, 전공별 지도박사님이 1:1로 밀착 지도해요. 지도교수님께 반려된 논문의 ‘심폐소생’, 정교한 통계분석, AI 활용 오류 수정이 특기예요. 무료상담에서 데이터 상태를 같이 보고 필요한 작업 범위를 안내해 드려요.
함께 보면 좋은 글 ▶ 통계 논문심사 답변 요령, 심사위원이 물어봤는데 모를 때 어떻게 말해야 할까요? 3초 안에 답하세요!
자주 묻는 질문 (FAQ)
Q. 데이터클리닝 방법 중 가장 먼저 할 일은 무엇인가요?
A. 원본 백업과 코딩 오류 점검이에요. 역코딩 누락과 범위 이탈값을 먼저 잡으세요. 이것만으로 신뢰도가 크게 달라지는 경우가 많아요.
Q. 불성실 응답자는 몇 명까지 지워도 되나요?
A. 정해진 인원은 없어요. 분석 전에 정한 기준에 해당하는 응답만 지우세요. 지운 뒤 남은 표본이 분석 목적에 충분한지 확인해야 해요.
Q. 결과가 안 나오면 이상치를 더 지워도 되나요?
A. 안 돼요. 삭제 기준은 분석 전에 정해야 해요. 결과를 보고 기준을 바꾸면 연구윤리 문제가 돼요.
Q. 변환해도 정규성이 안 나오면 어떻게 하나요?
A. 대안 추정법을 쓰세요. MLR이나 부트스트래핑, 비모수 검정을 선택할 수 있어요. 변환을 반복하기 전에 이상치와 불성실 응답을 다시 점검하세요.
결론 및 요약
핵심만 세 가지로 정리해 드릴게요.
- 데이터클리닝 방법은 순서가 중요해요. 코딩 오류, 불성실 응답, 문항 정제, 왜도·첨도 보정 순으로 가세요.
- 삭제는 기준을 먼저 정하고 하나씩 해요. 전후 지표를 비교하고 기록을 논문에 남기세요.
- 정규성이 안 나와도 길이 있어요. 변환, MLR, 부트스트래핑, 비모수 검정 같은 대안을 쓰면 돼요.
데이터는 모았는데 숫자가 안 나올 때의 막막함은 겪어 본 사람만 알죠. 통계를 몰라서 못 하는 게 아니니 자책하지 마세요. 혼자 문항을 지웠다 되돌렸다 하지 마시고 머스트논문 무료상담에서 데이터를 같이 살펴보세요. 필요한 만큼만 합리적인 비용으로 도와드릴게요!
[ 🏆 머스트논문 논문컨설팅 무료상담 ]
▶ 홈페이지 : https://must.kr
▶ 카톡상담 : https://pf.kakao.com/_xckbdX
▶ 이메일 : help@must.kr
▶ 대표전화 : 010-4868-0017
